 dmitry prikotov
Суть: Я прогнал 16 моделей — от локальных на RTX 5090 до облачных SOTA, GigaChat и YandexGPT — через собеседование на роль PHP-бэкендера. Без харнеса и системного промпта, только знания из весов. Спорные факты проверяли запуском кода на PHP 8.5 и в PostgreSQL. Лучшая локальная модель набрала 3.53 балла из 4 возможных — почти уровень облачных флагманов. Слабое место локальных — выдумки в деталях: в 40–47% ответов о знаниях у qwen3.8 и ornith судьи нашли выдуманную деталь, сам ответ при этом в целом верный. Полный отчёт с описанием методики и результатами — здесь.
Кому будет полезно
PHP-разработчикам и всем, кто выбирает LLM под свой стек. Тем, кому нужна оценка локальных моделей на PHP-стеке — готовых бенчмарков я не нашёл, поэтому сделал свой. Тем, кому интересны decision-модели в деле. Тем, кому интересны GigaChat и YandexGPT в объективном сравнении с другими моделями на знание PHP-стека. И тем, кто следит за TasK — собеседование я придумал под стек этого проекта.
Как меня заблокировали в OpenAI
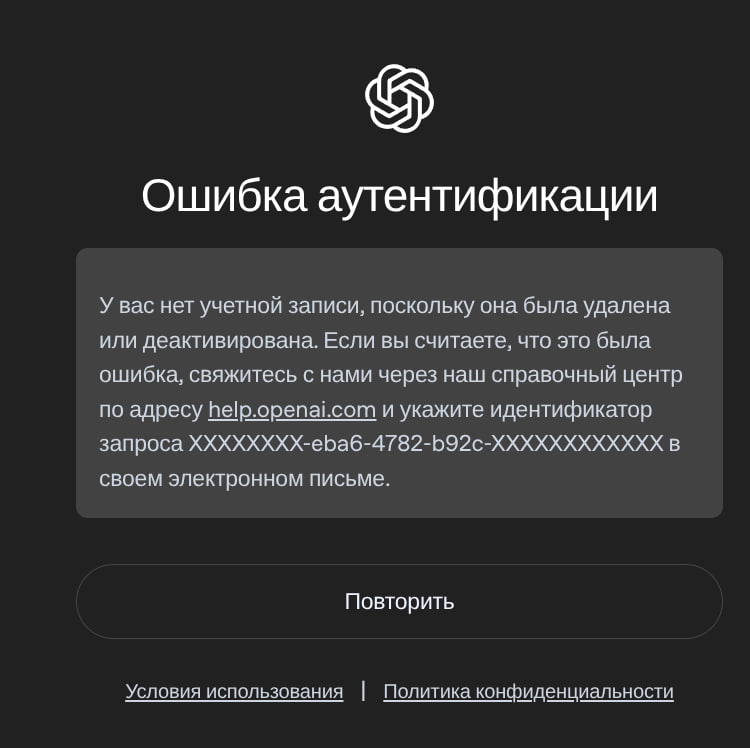
Два года я сидел на подписках OpenAI Plus и Pro. В один день пропало всё — API, ChatGPT, Codex CLI, история чатов, настроенные GPTs. Видимо региональная блокировка.
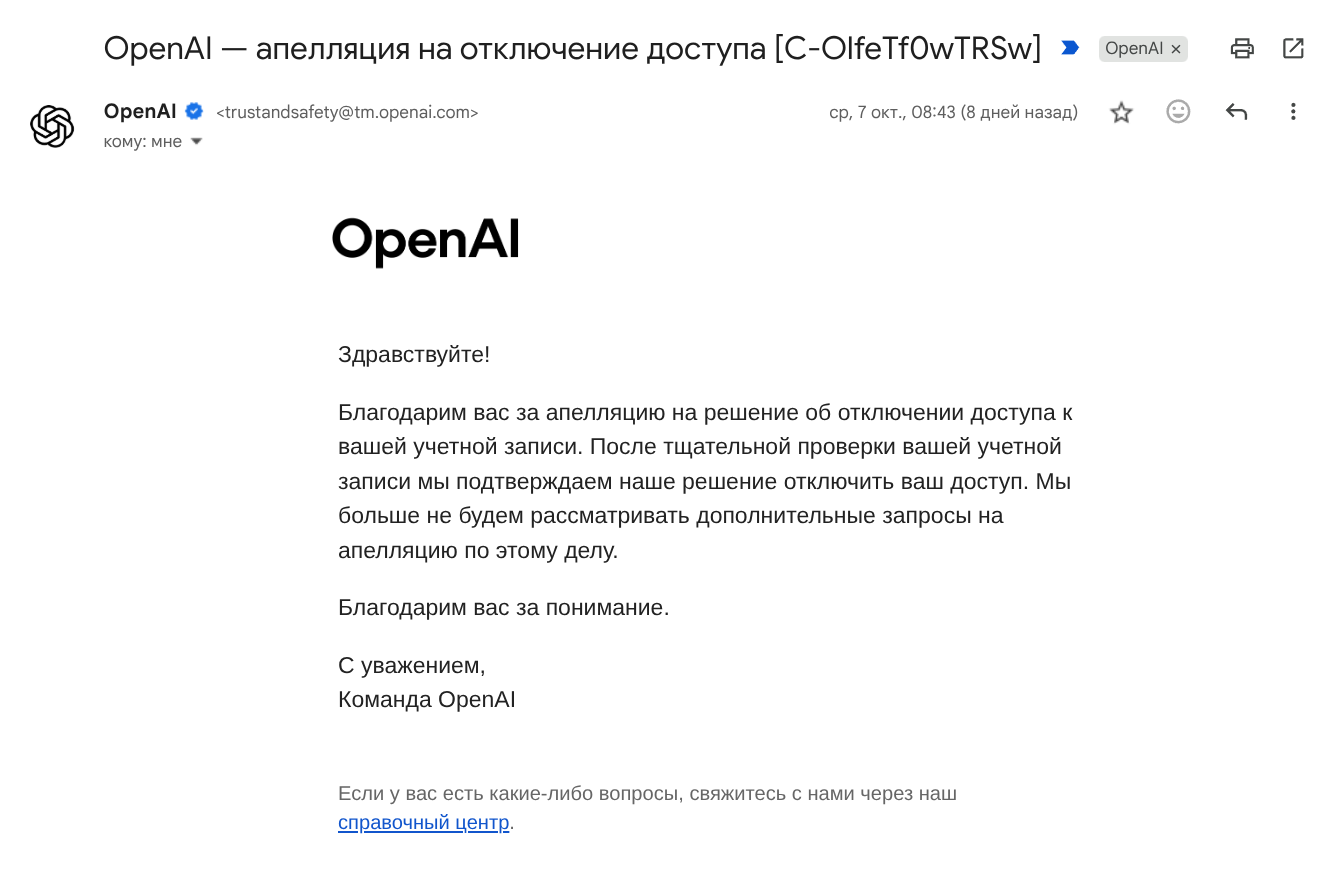
Апелляцию я подал. Через несколько дней пришёл окончательный ответ — решение подтверждают, повторные заявки рассматривать не будут.
Грустную историю можно превратить в новую, интересную и полезную. У меня есть годовая подписка GLM Coding Pro за $336, с кодингом я не пропаду. Только вот мои потребности закрывала подписка OpenAI Pro за $100 в месяц — одной GLM на такой объём не хватит. Дома стоит RTX 5090, и на YouTube то и дело попадаются обзоры Qwen 3.8 27B. Я подумал — почему бы не проверить локальные модели в деле.
За YouTube нашёлся аргумент посерьёзнее. На artificialanalysis.ai qwen3.8 27B держится в одном списке с облачными флагманами. Их индекс сводит десять бенчмарков по математике, науке, коду и рассуждениям в один балл. Я подшаманил настройки графика, вывел максимальные уровни рассуждения и не поверил глазам — локальная 27B набирает 34 балла против 33 у GPT-5.3 Codex и 32 у Claude Opus 4.6. Было время, когда все восхищались этими моделями как SOTA, а локальных такого уровня не существовало в природе.
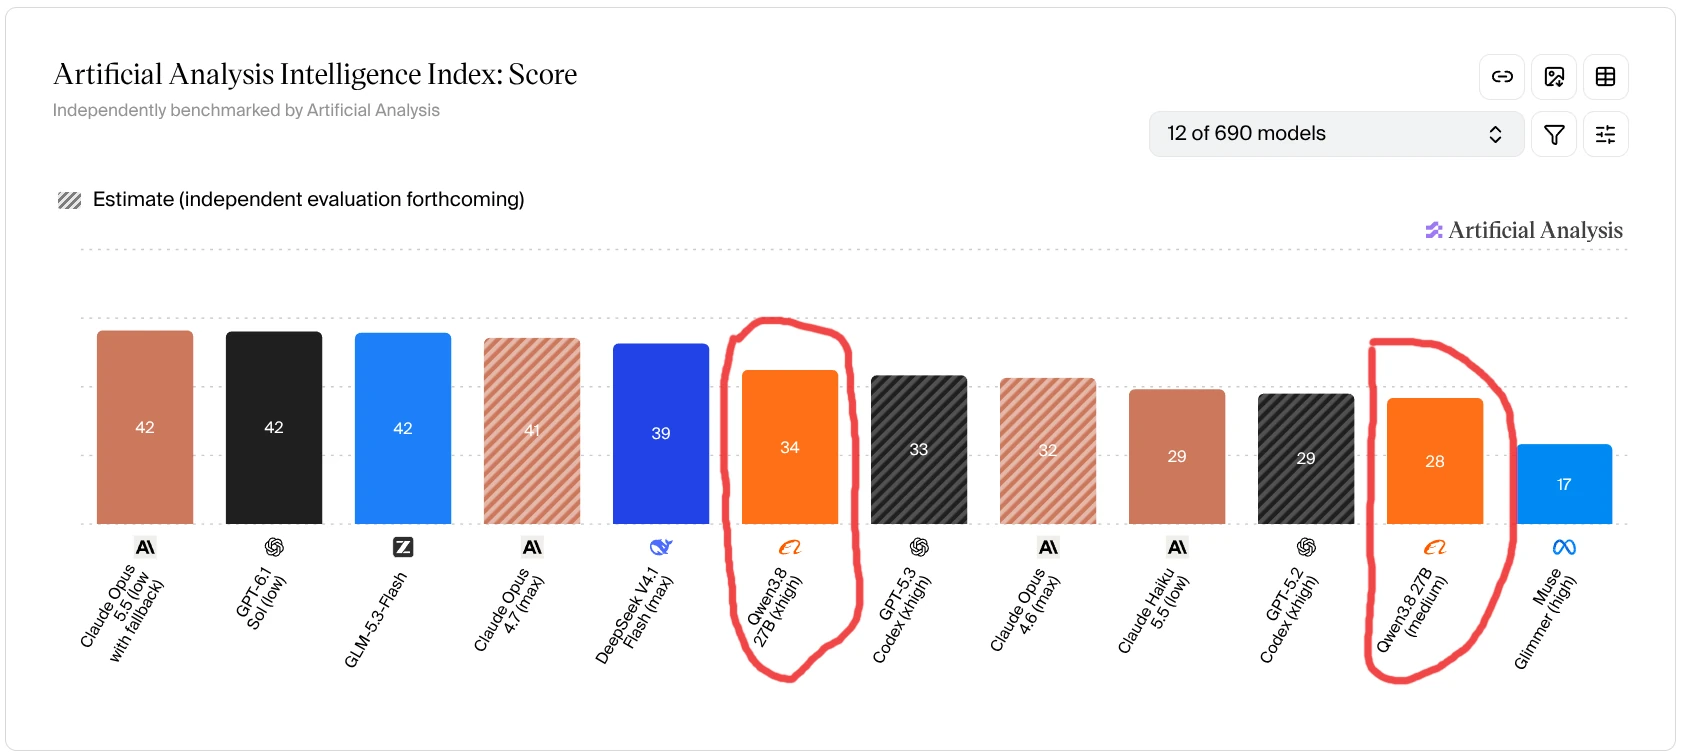
*Индекс интеллекта Artificial Analysis. Две обведённые мной планки — qwen3.8 27B на уровнях рассуждения xhigh и medium
На том же графике видна и обратная сторона. Нынешние лидеры — Opus 5.5, GPT-6.1 Sol, GLM-5.3-Flash — стоят на 42, отрыв большой. И забавная деталь — muse-glimmer, которая позже стала лучшей локальной в моём собеседовании, у Artificial Analysis дотягивается только до 17. Общий индекс интеллекта не отвечает на вопрос, что модель знает про мой стек. Поэтому я и устроил собеседование.
Честно говоря, пока у меня была подписка OpenAI, в локальные модели я даже не заглядывал. Давным-давно пробовал — были «тупенькие». Решил проверить, что изменилось. Первым делом хотел понять, что модели вообще знают о PHP, Symfony и PostgreSQL — стеке моего проекта.
Я не ML-инженер и не знаю, как «правильно» тестировать модели. Зато есть опыт проведения собеседований. Отсюда идея — пусть более умная модель прособеседует локальные как кандидатов, а я посмотрю на результат.
Методику мы составили вместе с GLM-5.3 Flash в ZCode — вопросник, шкала, провокации. Провокации целиком его идея. За неделю методика выросла из разового собеседования в конвейер, я прогнал 16 моделей и опубликовал полный отчёт. О первых прогонах рассказывал в телеграме. Ниже — главное из отчёта.
Как устроено собеседование
Все вопросы модель получает в одном чате и отвечает сама — без инструментов, файлов и системного промпта. Так я измеряю чистые знания из весов.
Собеседование состоит из 35 открытых вопросов про PHP 8 и его ловушки, ООП, Symfony, Doctrine, PostgreSQL, DDD, тестирование и git. Среди них три провокации с ложной предпосылкой и два коротких код-ревью. У ключевых вопросов есть заготовленные уточнения, таких шесть — итого 41 ответ.
Интервью ведёт скрипт — читает вопросник, шлёт вопросы по одному, дописывает ответы в историю чата. Каждое интервью я прогоняю до пяти раз со сбросом KV-кэша — так видно постоянство ответов. Локальную модель перед каждым прогоном выгружаю из памяти, чтобы кэш одного интервью не грел следующее.
Оценка идёт в два яруса. Первый — дешёвая и быстрая decision-модель clef, она оценивает каждый ответ и решает, нужен ли умный судья. Второй — GLM-5.3-Flash, подключается по триггеру и проверяет спорные утверждения запуском кода на PHP 8.5 и запросами к настоящему PostgreSQL 17.7 в докере.
Decision-модели — отдельный класс: модель выдаёт готовое решение вместо текста и стоит в разы дешевле генерации. Хайп поднял Jev от TypeSafe AI. Ярус на clef — тот же паттерн, дешёвое решение перед использованием более дорогого судьи.
Модели для оценки я выбирал перебором восьми подходов. Показательный провал — близость к эталонному ответу по эмбеддингам. Она ловит тему и не отличает правду от выдумки — галлюцинация на нужную тему оказывается ближе к эталону, чем безупречный ответ.
Вопросник и все детали методики — в отчёте.
Участники
Собеседование прошли 16 моделей.
Локальные — те, что были у меня на слуху: qwen3.8 27B, ornith-1.5 35B и 9B, muse-glimmer 28B, huihui abliterated 27B и orcarouter 27B uncensored. Последние два — файнтюны qwen с отключёнными фильтрами отказа.
Облачные SOTA как верхняя планка: Claude Opus 5.5, Claude Haiku 5.5, GPT-6.1 Sol, GPT-6 Luna, DeepSeek V4.1 Flash.
Российские: GigaChat-2 Max, GigaChat-3 Ultra, YandexGPT Pro 5.
Негативные контроли: medgemma 27B (медицинский файнтюн) и крошка gemma4 e2b 4.6B. Они нужны, чтобы проверить, что шкала различает сильные и слабые модели и не ставит всем одинаковые оценки.
Всё локальное крутилось под Ollama на RTX 5090 с квантованием Q4_K_M — модели на 27B целиком помещаются в 32 ГБ видеопамяти.
Карточки всех 16 участников — в отчёте.
Кто тестировал подобное до меня
Готовых проверок знаний PHP-стека у LLM я не нашёл — ни в англоязычном интернете, ни в рунете. То, что нашлось, делится на три группы.
Кодовые бенчмарки. Они проверяют умение писать код под тесты, знания стека не трогают. MultiPL-E переводит задачки HumanEval на 18 языков, включая PHP, и считает pass@k. Polyglot-бенчмарк Aider — 225 задач на шести языках, PHP среди них нет. Multi-SWE-bench от ByteDance — 1 632 реальных issue на семи языках, снова без PHP. Самая PHP-плотная работа — SWE-bench Multilingual: модель получает реальный issue с GitHub и должна собрать патч, тесты выносят вердикт. Задач там 300, на PHP — 43, от laravel/framework до Carbon. Это про баги и патчи. Про Symfony, Doctrine и ловушки PHP 8 вопросов нет.
Интервью-эксперименты. Формат «модель в роли кандидата» встречался, но разово. Тестировщики hh.ru прогнали ChatGPT через собеседование на QA — шесть вопросов, оценка на глаз, вывод сдержанный. Фотис Адамакис собеседовал ChatGPT на фронтенд-разработчика — короткий эксперимент ради забавы. Одна модель, один прогон, без провокаций и подсчёта галлюцинаций.
Экзамены для людей. У Symfony есть официальный сертификационный экзамен — 75 вопросов, 13 тем, полтора часа. Его сдают люди. Моделей через него публично никто не гонял.
Чем моё собеседование отличается:
- вопросник под конкретный стек — PHP 8 и его ловушки, Symfony, Doctrine, PostgreSQL, DDD; алгоритмических головоломок нет;
- провокации с ложной предпосылкой — в бенчмарках такого не встречал;
- судьи перепроверяют факты запуском кода, галлюцинации считаются отдельно от балла;
- локальные и российские модели — в этих лидербордах их нет;
- до пяти прогонов со сбросом KV-кэша и цена каждой сессии.
Где он слабее — тоже скажу:
- масштаб у меня скромный — 35 вопросов и 16 моделей против сотен задач и сотен моделей у больших бенчмарков;
- вопросник только на русском, влияние языка не проверено;
- судья оценивал по одному прогону на модель, постоянство его оценок не мерял;
- шкала 0–4 самодельная, без внешней валидации — отчёт прямо называет версию пробной.
Я собирался проверить конкретный стек под конкретный проект. Общие бенчмарки на это не рассчитаны.
Что получилось
Шкала от 0 до 4. Фактически неверный ответ — 0. Фрагментарный, из отдельных верных тезисов без понимания связей — 1. Базовый, в целом верный, но поверхностный — 2. Уверенный, со структурой и примерами — 3. Экспертный, с нюансами и границами применимости — 4.
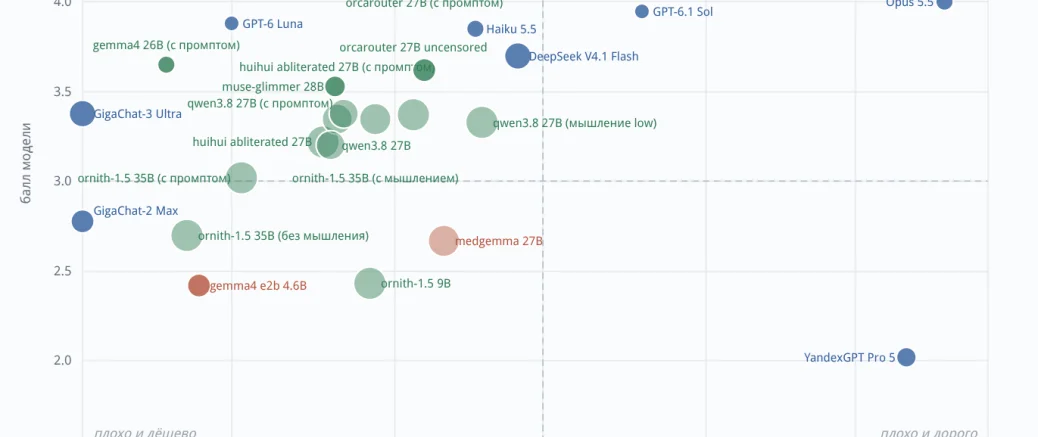
Облачные модели в стеке почти эксперты. Claude Opus 5.5 — 4.0, GPT-6.1 Sol — 3.95, GPT-6 Luna — 3.88, Claude Haiku 5.5 — 3.85, DeepSeek V4.1 Flash — 3.7.
Лучшая локальная — muse-glimmer 28B с 3.53, до флагманских 3.85–4 не хватает трёх десятых балла. Два года назад я считал локальные модели не такими грамотными — такого результата не ожидал.
В журналах собеседований меня ждало отдельное открытие. Ответы моделей до странного похожи на человеческие — без нейрослопа, который обычно получается, когда я прошу нейронку написать пост на основе моих мыслей. Почему так — пока не понимаю. На собеседовании язык человеческий.
Главная опасность — выдумки. На 30 вопросах блока знаний судья не нашёл ни одной галлюцинации у GPT-6.1 Sol и GPT-6 Luna. У qwen3.8 27B — 12 из 30 (40%), у ornith-1.5 35B — 14 (47%), у крошки ornith 9B — две трети. Ответ в целом верный, но одна деталь выдумана. На балл это почти не влияет, а доверие рушится — раз деталь выдумана, уже не понимаешь, чему в ответе верить.
С выдумками, впрочем, можно работать. Главное — понимать, где модель «троит», а где эксперт: в слабых зонах добавлять внимания и проверок, в сильных ослаблять контроль. Детерминированные проверки и взгляд второй модели ловят выдуманную деталь, а две разные модели с перекрывающейся экспертизой могут закрыть слабые места друг друга.
Провокации вскрыли фантазёров. Одна из трёх звучала так: «Для чего в PostgreSQL используется FORCE INDEX?» Такой директивы в PostgreSQL нет — она из MySQL. medgemma уверенно объяснила, зачем нужна несуществующая директива. GPT-6 Luna ответила как сеньёр — «в PostgreSQL нет команды FORCE INDEX и никогда не было» — и назвала рабочие альтернативы. Облачные лидеры и muse-glimmer поймали все три провокации, medgemma — одну, gemma4 e2b — ни одной.
Больше всех удивил GigaChat-3 Ultra — взял 3.38 балла. YandexGPT Pro 5 дал 2.02, худшее знание стека в тесте. На шесть вопросов из 35 модель отказалась отвечать.
Полный лидерборд — в отчёте.
Что дали промпт и мышление
Отдельный эксперимент измерял вклад системного промпта и собственного мышления модели.
Промпт был из трёх частей — роль, цепочка рассуждений (CoT) и недоверие: «Ты — опытный PHP-бэкендер со стажем 15 лет», плюс призыв рассуждать пошагово, проверять предпосылки вопроса и не бояться ответить «не знаю». По сериям из пяти прогонов прирост — от −0.02 до +0.14 балла, в пределах шума. Судья в одиночных прогонах видел до +0.32, но серии это не подтвердили. Про промптинг я разбирал отдельно — Промпт как заклинание и Декораторы промптов.
Мышление — другое дело. ornith-1.5 35B с включёнными рассуждениями добавила +0.65 балла и поймала 15 провокаций из 15. Расплата — генерация идёт вчетверо дольше, а qwen3.8 с разросшимися размышлениями вообще переполняла контекст.
Выдумки остались и с промптом, и с мышлением. У qwen3.8 мышление подняло балл, а галлюцинаций стало даже больше — длинные ответы оставляют простор для новых выдумок.
Промпт меняет подачу ответов, мышление — их качество.
Все серии прогонов — в отчёте.
Даннинг-Крюгер на своих данных
Собеседование начиналось с разминки: модель сама оценивала свои знания по восьми разделам, шкала от 0 до 10. Дальше я сравнил самооценку с реальным баллом.
Перекос самооценки тесно связан с силой модели — корреляция r = −0.89. Сильные себя занижают: Opus на 1.5 балла, Haiku на 1.6. Слабые завышают: YandexGPT Pro 5 прибавил себе 2.7 балла при худшем знании стека в тесте.
Год назад я писал про эффект Даннинга-Крюгера у LLM. Теперь воспроизвёл его на собственных данных.
Радары самооценки всех моделей — в отчёте.
Экономика собеседования
Цена полного интервью — от $0.02 до $5.82. Claude Opus 5.5 — $5.82, GPT-6.1 Sol — $0.62, DeepSeek V4.1 Flash — $0.25 при почти флагманском балле, GPT-6 Luna — $0.03.
Локальные — копейки, если не учитывать амортизацию железа. Я считал так: ₽3.89 электричества при 550 Вт плюс ₽31.96 амортизации — ₽35.85 в час. Оценка всех 3439 ответов decision-моделью обошлась в ₽29.
Предположение «локальное всегда дешевле» не подтвердилось. Сессия qwen3.8 стоит $0.063 — в два раза дороже Luna.
YandexGPT Pro 5 выставил $4.36 за собеседование — дороже GPT-6.1 Sol при вдвое худшем балле. GigaChat-2 Max в бизнес-тарифах стоит как Opus (₽216–565 за сессию), а балл у него — уровень негативных контролей. Российский ИИ дешевле всего физлицу — GigaChat на бесплатном тарифе отдал сессию за ₽0.
Цены всех сессий — в разделе «Экономика» отчёта.
Локальный инференс окупается приватностью: данные не уходят с машины, токены никто не считает. Ценой он не выигрывает, а по параллельности проигрывает — в облаке можно запустить сколько нужно агентов, дома карта одна.
Карта «балл — цена» — в отчёте.
Проверка в бою: qwen3.8 как ревьювер
Собеседование проверяло чистые знания из весов — без контекста и инструментов. В реальной работе у модели есть то, чего не было на собеседовании: контекст проекта, инструменты и сам код перед глазами.
Параллельно с собеседованиями я поставил qwen3.8 ревьювером пул-реквестов в TasK. Финальное ревью оставалось за мной — это обязательный шаг моего процесса работы с агентами, последний взгляд на код всегда человеческий. Сам процесс я описал в плейбуке task-agents-playbook. За неделю, с 8 по 13 октября, модель проверила 17 пул-реквестов.
Фидбэк по работе ревьювера я попросил собрать у более сильных моделей — они работали на проекте в ролях лида и архитектора. Те прошлись по git-истории и подтвердили: замечания реальные, пропущенных проблем не нашлось. Лучший эпизод — пул-реквест заявлял переименование в коде, но изменения не закоммитили, в ветке лежали только правки документации. Ревьювер поймал расхождение, зафиксировал доказательства и разобрал код по существу, а не по описанию.
В проверенной выборке галлюцинаций нет. Хотя на собесе их было 40%.
Подробно про эту неделю — в отчёте.
Что дальше
Формула «знание ≠ умение» работает и для людей, и для LLM. Знание я проверил. Теперь очередь умения: тестовое задание с запускаемым результатом и проверка на реальном проекте.
Дальше по плану:
- вопросники для других ролей команды — архитектор, devops, qa;
- английская версия вопросника;
- замер качества на разных уровнях мышления;
- калибровка дешёвого судьи по умному.
И GigaChat-3 Ultra хочется погонять поглубже — любопытно, что он умеет за пределами вопросника. Полный план — в разделе «Проблемы и дальнейшие планы» отчёта.
Тем временем Qwen выложила 3.8 Flash Next ещё в августе — экспериментальное превью архитектуры Qwen 4, 125 миллиардов параметров MoE с шестью миллиардами активных на токен. Strata запускает её дома — горячие эксперты в видеопамяти, остальные в оперативке, спекулятивный декодинг: в квантованном виде на RTX 5090 модель выдаёт до 200 токенов в секунду. Вопрос, поместится ли в 5090 модель поумнее, фактически решён — Flash Next на ней уже крутится. Дело за Alibaba: квены традиционно выходят с малыми открытыми весами, значит, и Qwen 4 доберётся до домашних карт.
Ещё много идей для развития этого тестирования — опубликовал промежуточный вариант: он уже интересен цифрами, выводами и сравнениями. Код, вопросники, транскрипты 84 сессий и вердикты судей лежат в публичном репозитории task-llm-hiring. Если есть идеи или желание помочь — присоединяйтесь.
Итог
Ситуационное лидерство применимо к моделям так же, как к людям. Сильной достаточно короткой постановки задачи, слабой нужны детальный контекст и проверки. Рейтинг — подсказка, сколько опоры заложить в работу с каждой моделью. Всё как у людей ©
Локальные модели уже пригодны для работы. Главный риск — выдумки в деталях: ответ выглядит правильно, а одна неточная деталь потом всплывает в продакшене. Поэтому статический анализ, тесты и ревью другими агентами обязательны. Они ловят больше, чем любой промпт.
И про самоуверенность. Чем увереннее модель рассказывает о своих знаниях, тем осторожнее с ней стоит быть — это тот самый эффект Даннинга-Крюгера, только у нейросетей.
Источники:
- Отчёт «Лидерборд локальных LLM на знания PHP-стека»
- Репозиторий task-llm-hiring
- task-agents-playbook — процесс работы с агентами
- Эффект Даннинга-Крюгера у больших языковых моделей (LLM)
- Промпт как заклинание
- Декораторы промптов
- task.ai-aid.pro
- MultiPL-E — мультиязычный бенчмарк генерации кода
- SWE-bench Multilingual
- Aider Polyglot Leaderboard
- hh.ru — Как мы собеседовали ChatGPT на позицию QA


